外观
知识库管理
概述
知识库管理模块代码位于 backend/app/api/v1/module_ai/knowledge)。基于 RAG(检索增强生成)思路,提供从文档入库、智能切分、向量化到语义检索的完整链路。它与「模型管理」「智能对话」协同:知识库负责把私域文档变成可被大模型检索的向量数据,对话时再按需召回,从而让回答有据可依。
整体定位
知识库的数据以三层结构组织,另由一条解析任务记录串联:
- 知识库(Knowledge):RAG 的容器,承载一套检索配置(嵌入模型、召回数量、相似度阈值、检索策略、重排模型等)。一个知识库下可挂载多篇文档。
- 文档(Document):知识库中的内容来源,分「本地上传」与「网络链接」两类。文档仅落库、不直接参与检索。
- 分段(Segment):文档经切分、向量化后的最小检索单元,真正被写入向量库并参与召回。支持父子分块结构(父块承载上下文、子块用于检索)。
- 解析任务(Task):记录一次「切分 + 向量化」任务的执行状态与配置指纹,用于进度追踪与分段复用。
数据流转与解析流程
文档从入库到可检索经历「上传/创建 → 排队 → 解析(读文件→切分→向量化→落库)→ 完成」的完整流程,解析由后台任务队列(ARQ Worker)异步执行,期间通过数据库与 WebSocket 双通道回写进度。
几个关键设计点:
- 上传与解析解耦:本地上传只落库不解析;网络链接在创建时自动触发异步解析。用户可单独对多篇文档批量触发解析。
- 配置指纹复用:每次解析都会基于「文档内容 + 分块参数 + 嵌入模型」计算 SHA1 指纹。若指纹未变化且分段仍存在,直接复用既有分段,跳过耗时解析。
- 实时进度:Worker 各阶段回写进度,并通过 Redis 广播的 WebSocket 消息(
ai_knowledge_document_progress)跨进程推送到前端,前端也支持轮询兜底。
知识库配置
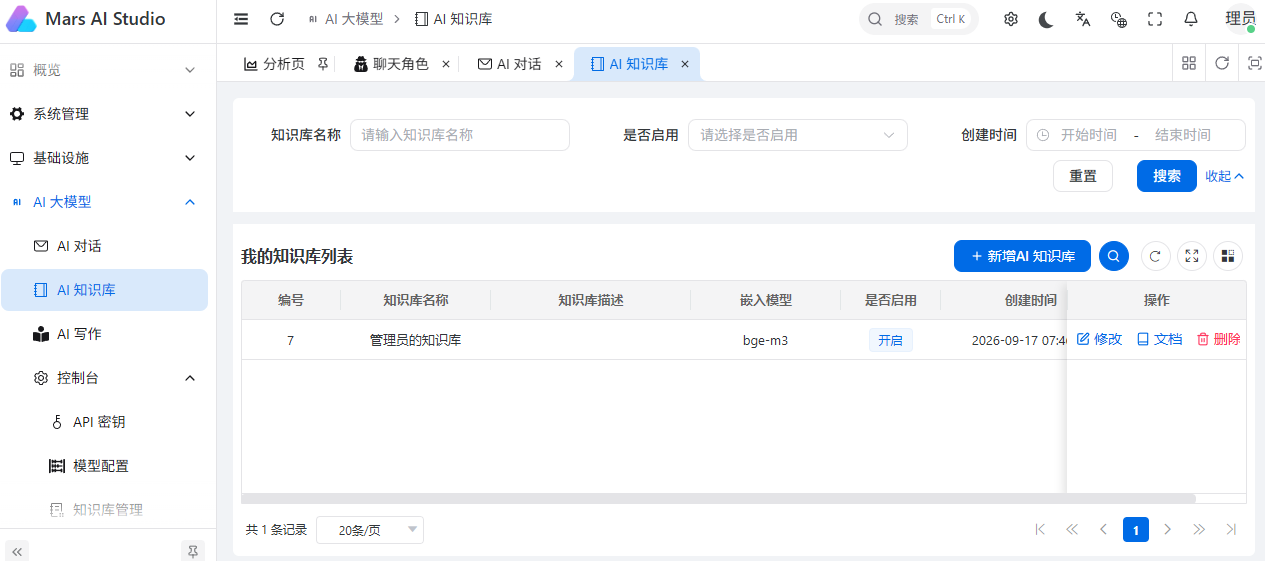
创建或更新知识库时,可配置以下检索相关项(管理端全量维护,用户端创建则强制归属本人且私有):
- 嵌入模型(Embedding):用于把分段文本转成向量,必须选择
EMBEDDING类型的模型;其标识会冗余存储,便于检索阶段对齐。 - 召回数量 top_k:一次检索最终返回的分段条数。
- 相似度阈值:0~1,重排后用于过滤低相关结果,0 表示不做阈值过滤。
- 检索策略(retriever_name):缺省为向量检索,可在检索管道中扩展更多策略。
- 重排模型(Rerank):可选,选
RERANK类型模型,用于两阶段召回中对粗召回候选做精排。 - 检索器参数(retriever_params):如粗召回数量
recall_k,管道会以top_k * RECALL_MULTIPLIER放大候选集供重排淘汰。
文档管理
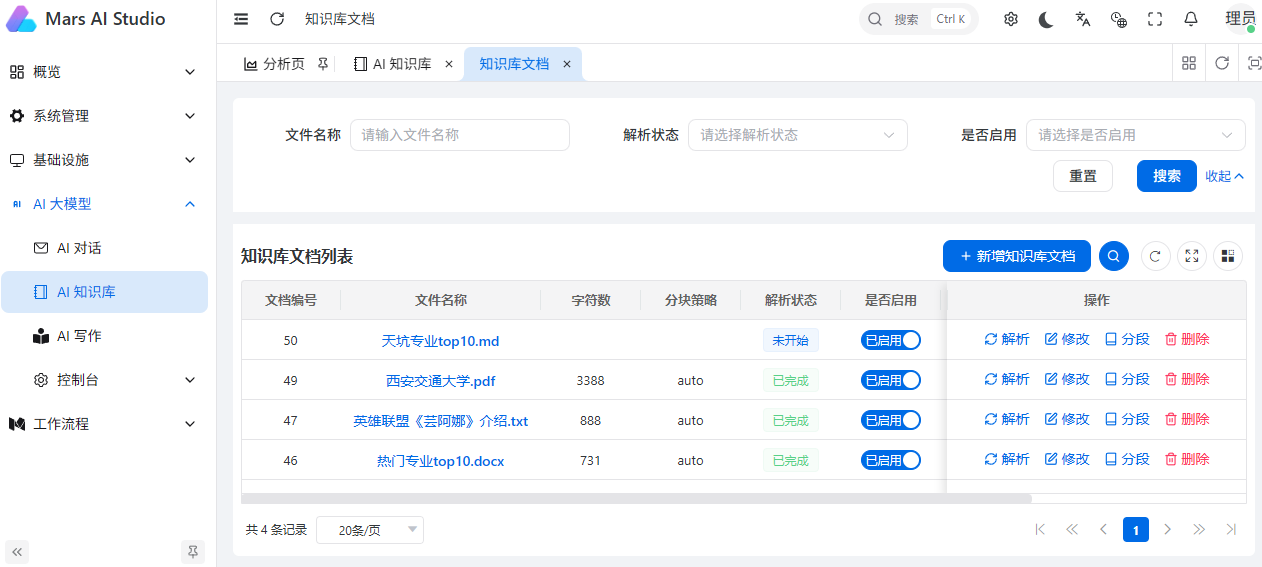
文档分两类来源:
- 本地上传:通过
multipart/form-data上传文件,支持自动按扩展名过滤。上传时按内容 SHA1 指纹在同知识库下去重,文件落盘到基础设施文件存储(ai/knowledge目录)。 - 网络链接:提交 URL 创建,系统自动下载内容并在创建时触发异步解析。
文档状态与解析状态独立:
- 启用/禁用(status):控制文档是否参与检索,禁用会级联同步其分段与向量节点的状态元数据。
- 解析状态(parse_status):未开始 / 已排队 / 解析中 / 已完成 / 失败 / 已取消。重复触发时会跳过「已排队/解析中」的文档,避免重复投递;可手动取消正在进行的解析。
切分与分段
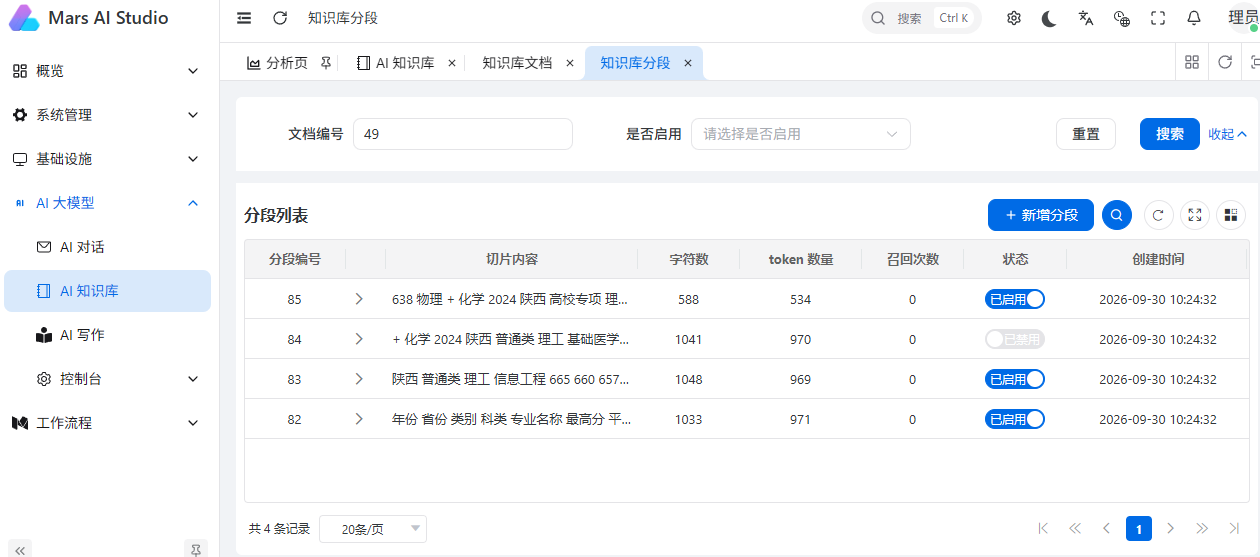
切分由 Splitter 工厂基于 LlamaIndex 的原生解析器实现,支持多种策略,可按文件名在 auto 模式下自动选择:
| 策略 | 说明 |
|---|---|
| auto | 按文件扩展名自动选择(md→markdown、html→html、json→json、代码→code,其余→sentence) |
| sentence | 按句子边界切分 |
| token | 按 Token 数量切分 |
| markdown | 按 Markdown 标题层级结构化切分 |
| code | 按代码语法结构切分(需指定语言) |
| html / json | 按 HTML / JSON 结构切分 |
| semantic | 按语义相似度切分(需传入 Embedding 模型) |
| sentence_window | 句子窗口切分,保留上下文窗口供检索 |
| parent_child | 父子分块,父块供上下文、子块供检索 |
切分参数主要包含「分块大小」「重叠大小」「分块策略」三项,调整参数不会自动重建,需用户重新触发解析(由配置指纹自动判定是否需要重建)。系统提供「分块预览」接口,仅切分不落库、不向量化,便于上传前确认切分效果。
父子分块落库时,父块先入库(不带向量),子块通过关系回填 parent_id;检索命中走子块,上下文可回溯父块。
向量数据库
向量存储由 LlamaVectorStoreFactory 统一封装,基于 LlamaIndex 适配多种后端,按 backend:collection_name 缓存实例:
- chroma:本地持久化(默认
CHROMA_PERSIST_DIR),开箱即用,适合开发环境 - milvus:分布式向量库,需配置
MILVUS_URI/USER/PASSWORD/DIM。 - pgvector:复用 PostgreSQL,需配置连接与
embed_dim(向量维度)。 - qdrant:需配置
qdrant_url与可选qdrant_api_key。
后端类型与集合名由框架配置(VECTOR_STORE_BACKEND、VECTOR_STORE_COLLECTION 等)决定,显式入参优先。
检索与召回
检索管道(RetrievalPipeline)编排两阶段召回流程:检索器粗召回(以 top_k * 5 放大候选)→ 可选 Rerank 重排 → 相似度阈值过滤 → 截断 top_k。管道只负责编排,嵌入模型、向量存储、重排后处理器由调用方解析后注入,保证入库与检索使用同一套嵌入模型。
权限与归属
知识库模块同时提供「管理端」与「用户端(我的)」两套接口,区别在于数据归属:
- 管理端接口(如
/ai/knowledge/page、/ai/knowledge/document/parse)拥有ai:knowledge:*权限,维护全量资源,user_id为空表示公开资源。 - 用户端接口(以
-my结尾,如/ai/knowledge/page-my、/ai/knowledge/document/upload-my)仅依赖登录态,业务层强制把查询归属收窄为当前用户,删除/更新/解析等操作都会先校验知识库或文档确属本人,杜绝越权。
「我的」精简列表返回「管理端公开资源 + 本人私有」的启用知识库,供对话等场景选择可用知识库。
前端说明
前端页面位于 frontend/apps/web-ele/src/views/ai/knowledge/,按知识库、文档、分段三个维度组织,并配套 API 封装 frontend/apps/web-ele/src/api/ai/knowledge/。
- 知识库列表:
knowledge/manage(管理端)、knowledge/user(我的知识库),通过表单modules/form.vue维护名称、描述、嵌入模型、top_k、阈值、检索策略、重排模型等配置。 - 文档管理:
document/index.vue列表页,进入有document/form(上传向导:上传 → 分块预览 → 解析进度三步走)与document/create(网络链接)。解析进度通过进度接口轮询或监听ai_knowledge_document_progressWebSocket 消息实时渲染。 - 分段管理:
segment/index.vue查看与编辑某文档的分段,支持启禁用、内容修正与分块预览。 - 召回测试:知识库详情页内
knowledge/retrieval提供「文档召回测试」,输入问题即可验证当前检索配置的实际召回效果。
路由方面,文档、分段、召回测试等页面通过 router/routes/modules/ai.ts 配置为 hideInMenu 的子路由,由知识库列表页以 name 跳转进入(activePath 统一指回 /ai/knowledge),保持菜单聚焦在知识库主入口。
常见注意点
- 嵌入模型需先通过「模型管理」配置为
EMBEDDING类型且可用,否则文档向量化会失败并标记解析失败。 - 调整分块参数或嵌入模型后需重新触发解析,系统按配置指纹判断是否需要重建;内容相同则自动复用,避免重复消耗。
- 删除知识库会级联清理其下全部文档、分段与向量数据,删除文档会同步删除存储文件,操作不可恢复。
- 向量库状态与数据库分段状态通过
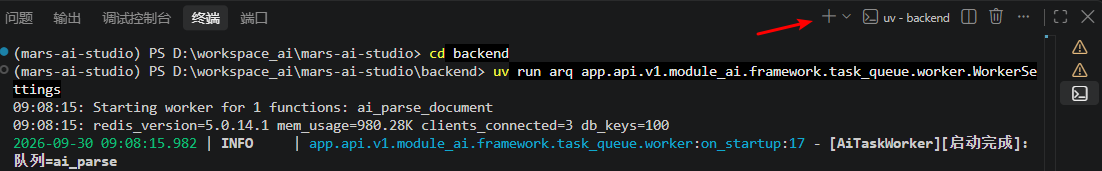
status元数据保持一致,禁用文档/分段后其向量不会被召回。 - 日常开发,需要在 VSCode 中新建终端, 启动 ARQ 进行文档解析。
bash
# 进入后端目录
cd backend

# 启动 ARQ
uv run arq app.api.v1.module_ai.framework.task_queue.worker.WorkerSettings