外观
Milvus安装与使用
Milvus
介绍
Milvus 是一款开源的高性能、高扩展性向量数据库,专为处理海量非结构化数据(如文本、图像、音频)的相似性搜索而设计,是构建 AI 应用(尤其是检索增强生成,RAG)的核心基础设施之一。
Milvus 三种版本
| 中文名称 | 英文名称 | 部署方式 | 适用规模 | 主要特点 |
|---|---|---|---|---|
| 轻量版 | Lite | 嵌入式(Python 库) | 几百万向量 | 轻量、本地文件存储、适合开发/边缘场景 |
| 单机版 | Standalone | 单机 Docker 容器 | 约 1 亿向量 | 功能完整、部署简单、适合中小生产环境 |
| 分布式版 | Distributed | Kubernetes 集群 | 数十亿~百亿向量 | 高可用、弹性伸缩、适合大规模生产系统 |
大规模生产环境,建议将 Milvus Standalone 安装于一台独立的服务器。Milvus Standalone v2.6.x 安装教程。
安装
环境准备
- Windows 上安装 WSL2
- WSL2 上安装 Ubuntu 22.04
- Ubuntu 22.04 上安装Docker
参考文档:《WSL与Docker》
安装Milvus单机版
以 Ubuntu 22.04 为例,以 Docker Compose 方式安装运行 Milvus (目前建议v2.6版本)
shell
# 建一个目录并进入该目录,例如
mkdir /opt/milvus && cd /opt/milvus

# 下载 Milvus 的 Docker Compose 配置
wget https://github.com/milvus-io/milvus/releases/download/v2.6.24/milvus-standalone-docker-compose.yml -O docker-compose.yml

# 下载镜像、启动容器
sudo docker compose up -d

# 查看状态
docker compose ps

# 设置重启策略
sudo docker update --restart unless-stopped milvus-etcd milvus-minio milvus-standalone
使用 Docker Compose 安装运行 Milvus ,会启动3个容器:milvus-standalone、milvus-minio 和milvus-etcd
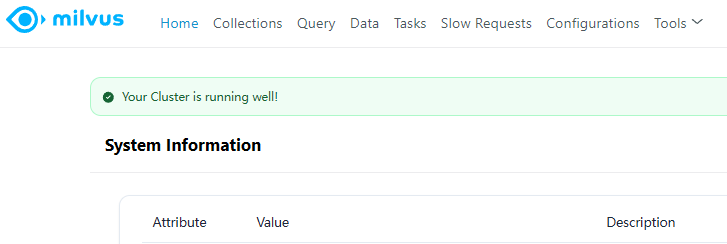
浏览器访问 Milvus Web UI。例如:http://127.0.0.1:9091/webui (修改为服务器IP)
- Milvus WebUI 详细信息,请参阅Milvus WebUI
查看数据
安装并使用 VectorDBZ 工具,连接到Milvus (修改为服务器IP) 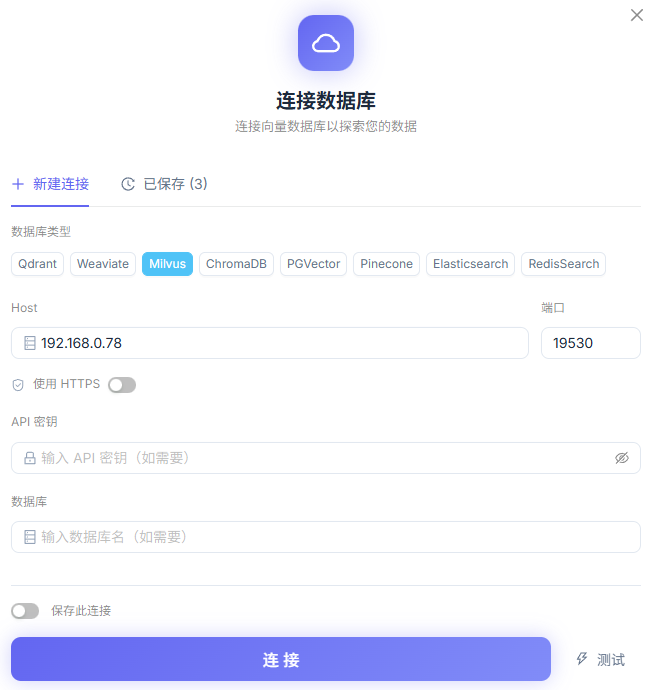
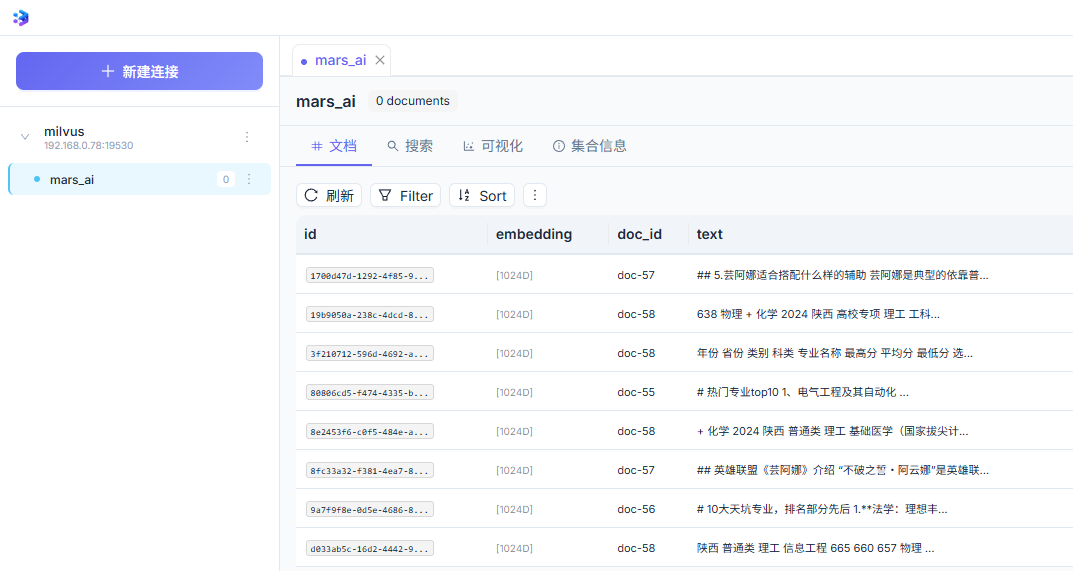
查看数据
注意
- VectorDBZ查看的数据非实时,只显示了Milvus已落盘数据
- VectorDBZ只能查看Milvus的default数据库中的集合
向量数据库
在 Milvus 中,数据库(Database) 是一个逻辑上的数据组织单元,为集合(Collection)提供了隔离和权限管理的边界。
python
# 安装SDK: pip install pymilvus

from pymilvus import MilvusClient

client = MilvusClient(uri="http://127.0.0.1:19530")

# 创建数据库
client.create_database(db_name="my_db")

# 查看数据库
print(client.list_databases())
print(client.describe_database(db_name="my_db"))

# 删除数据库
# client.drop_database(db_name="my_db")
# print(client.list_databases())可指定数据库属性,参考文档
向量集合
介绍
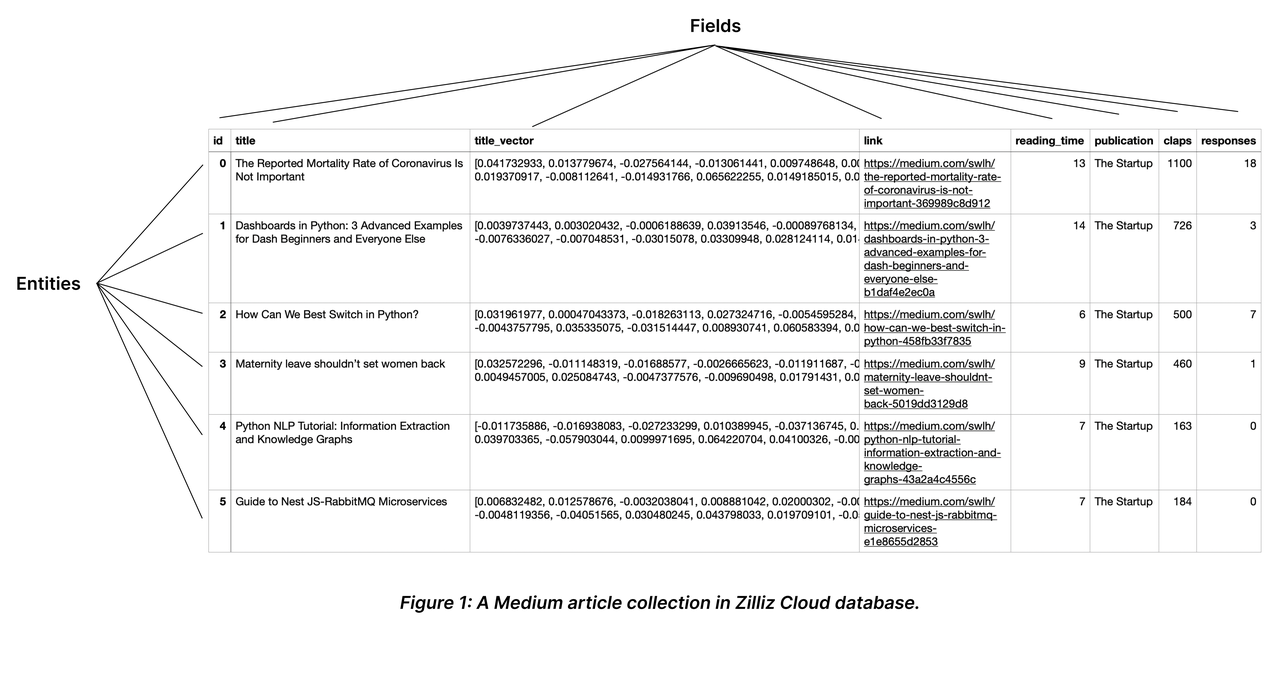
在 Milvus 中,集合(Collection) 是向量数据的基本组织单元,类似于关系型数据库中的“表(Table)”。集合是实际存储向量数据的地方,它定义了一套固定的数据结构(Schema)。
- 核心定义:集合可以看作一张二维表,每一列是一个字段(Field),每一行是一个实体(Entity)。在创建集合时,必须定义一个模式(Schema) 来规定字段的名称、数据类型(如整数、字符串、浮点向量)以及向量字段的维度。
主键与字段:每个集合必须有一个主键(Primary Key) 字段(如
id),用于唯一标识每个实体。如果启用了AutoId功能,Milvus 会在插入数据时自动生成主键值,插入时则无需指定。- 向量字段 (Vector Field):专门存储向量数据的字段(例如
vector) - 标量字段 (Scalar Fields):用于存储文本等元数据(例如
text)
- 向量字段 (Vector Field):专门存储向量数据的字段(例如
索引与加载:为了支持高效的向量相似性搜索,必须为向量字段创建索引。此外,集合中的数据默认保存在磁盘上,在执行搜索或查询前,需要先将集合加载(Load) 到内存中。反之,释放(Release) 集合可以节省内存开销。
分区与别名:你可以在集合内部进一步创建分区(Partition) 来水平切分数据,在搜索时指定分区可以缩小查询范围,提升效率。此外,集合支持设置别名(Alias),方便在应用程序中灵活切换底层集合。
| Milvus 概念 | 关系数据库(RDBMS)对应概念 | 说明 |
|---|---|---|
| Database | 数据库(Database) | 顶层容器,用于隔离不同项目或租户的数据。 |
| Collection | 表(Table) | 存储数据的核心单元,具有固定的字段结构。 |
| Entity | 行/记录(Row/Record) | 一条具体的数据,包含主键、标量字段和向量。 |
| Field | 列(Column) | 数据的属性,分为标量字段(如标题、ID)和向量字段。 |
| Partition | 无直接对应,类似分区表 | 集合内的逻辑子集,用于优化数据管理和查询(如知识库) |
下图中有8个字段,6个实体
创建集合
创建集合通常需要:定义 Schema、设置索引和创建集合对象。
python
from pymilvus import DataType, MilvusClient

# 定义 Schema
schema = MilvusClient.create_schema(enable_dynamic_field=True)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True,
    description="主键自增ID",
)
schema.add_field(
    field_name="vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=1024,
    description="向量数据",
)
schema.add_field(
    field_name="text",
    datatype=DataType.VARCHAR,
    max_length=4096,
    description="文本数据",
)
schema.add_field(
    field_name="source",
    datatype=DataType.VARCHAR,
    max_length=1024,
    description="数据源",
)

# 设置集合索引参数
index_params = MilvusClient.prepare_index_params()
index_params.add_index(field_name="id", index_type="AUTOINDEX")
index_params.add_index(
    field_name="vector", index_type="AUTOINDEX", metric_type="COSINE"
)

# 创建集合对象
client = MilvusClient(uri="http://127.0.0.1:19530", db_name="my_db")
client.create_collection(
    collection_name="my_collection", schema=schema, index_params=index_params
)

# 删除集合
# client.drop_collection(collection_name="my_collection")
集合添加数据
python
from pymilvus import MilvusClient, DataType

# 创建集合 my_color
schema = MilvusClient.create_schema(auto_id=False, enable_dynamic_field=True)
schema.add_field("id", DataType.INT64, is_primary=True)
schema.add_field("vector", DataType.FLOAT_VECTOR, dim=5)
schema.add_field("color", DataType.VARCHAR, max_length=512)

index_params = MilvusClient.prepare_index_params()
index_params.add_index(
    field_name="vector", index_type="AUTOINDEX", metric_type="COSINE"
)

client = MilvusClient(uri="http://127.0.0.1:19530", db_name="default")
client.create_collection(
    collection_name="my_collection", schema=schema, index_params=index_params
)

# 集合插入数据
client = MilvusClient(uri="http://127.0.0.1:19530", db_name="default")
data = [
    {
        "id": 10,
        "vector": [
            0.3580376395471989,
            -0.6023495712049978,
            0.18414012509913835,
            -0.26286205330961354,
            0.9029438446296592,
        ],
        "color": "pink_8682",
    },
    {
        "id": 11,
        "vector": [
            0.19886812562848388,
            0.06023560599112088,
            0.6976963061752597,
            0.2614474506242501,
            0.838729485096104,
        ],
        "color": "red_7025",
    },
    {
        "id": 12,
        "vector": [
            0.43742130801983836,
            -0.5597502546264526,
            0.6457887650909682,
            0.7894058910881185,
            0.20785793220625592,
        ],
        "color": "orange_6781",
    },
]
res = client.insert(collection_name="my_collection", data=data)
print(res)
查看集合状态
加载集合是在集合中进行相似性搜索和查询的前提。
- 注意查询与落盘数量的区别
python
from pymilvus import MilvusClient

client = MilvusClient(uri="http://127.0.0.1:19530", db_name="default")

# 列出所有集合
print(client.list_collections())

# 查看集合详细信息
print(client.describe_collection(collection_name="my_collection"))

# 加载集合
client.load_collection(collection_name="my_collection")

# 查看集合加载状态
print(client.get_load_state(collection_name="my_collection"))

# 查看集合已落盘实体数量
stats = client.get_collection_stats(collection_name="my_collection")
print(stats)

# 查询集合实时实体数量
res = client.query(
    collection_name="my_collection",
    filter="",
    output_fields=["count(*)"],
    consistency_level="Strong",
)
print(res)
排错
DataNotMatchException
报错信息
shell
pymilvus.exceptions.DataNotMatchException: <DataNotMatchException: (code=1, message=Insert missed an field `producer` to collection without set nullable==true or set default_value)>
 (decorators.py:221)
Failed to insert batch starting at entity: 1/13. First entity data: {'pk': '41258d07-ee15-4d6f-8857-66a063adbf61', 'text': '陕西师范大学2024年分专业录情况\n\n年份 省市 类别 科类 专业名称 录取人数 最高分 最低分 平均分 控制线 2024 陕西 公费师范生 理工\\物理类
数学与应用数学(国家公费师范生) 34 645 619 625.4 475 2024 陕西 公费师范生 理工\\物理类 英语(国家公费师范生) 4 631 618 623.8 475 2024 陕西 公费师范生 理工\\物理类 物理学(国家公费师范生) 60 627 605 611.8 475 2024 陕西 公费师范生 理工\\物理类 化学(国家公
费师范生) 55 635 603 610.5 475 2024 陕西 公费师范生 理工\\物理类 生物科学(国家公费师范生) 51 619 602 607.3 475\n\n陕西师范大学2024年分专业录情况', 'vector': '[-0.06054746, 0.01869538, -0.03117842, -0.022429377, 0.011095588, 0.0077479198, -0.020592848, 0.01760907, 0.026978241, 0.037383925]... (truncated, total len: 1024)', 'source': 'uploads\\陕西师范大学.md'}
<DataNotMatchException: (code=1, message=Insert missed an field `producer` to collection without set nullable==true or set default_value)>
原因分析
- Milvus集合模式(Schema)中定义了一个名为
producer的字段,但在实际插入的数据中缺少了这个字段,而该字段没有被设置为可空(nullable)或提供默认值(default_value)
解释方案
- 方案一:修改集合模式(推荐)
python
from pymilvus import FieldSchema, CollectionSchema, DataType

# 修改字段定义,添加 nullable=True
fields = [
    FieldSchema(name="id", dtype=DataType.INT64, is_primary=True),
    FieldSchema(name="text", dtype=DataType.VARCHAR, max_length=65535),
    FieldSchema(name="vector", dtype=DataType.FLOAT_VECTOR, dim=1024),
    FieldSchema(name="source", dtype=DataType.VARCHAR, max_length=512),
    FieldSchema(name="producer", dtype=DataType.VARCHAR, max_length=256, nullable=True)  # 设置为可空
]

schema = CollectionSchema(fields, description="文档集合")- 方案二:在插入数据中包含缺失字段
python
# 在准备插入数据时,确保包含producer字段
chunks_with_producer = []
for chunk in chunks:
    chunk.metadata["producer"] = "default_producer"  # 或者从文档中提取相关信息
    chunks_with_producer.append(chunk)

# 然后使用包含完整字段的数据进行插入
ids = await vector_store.aadd_documents(documents=chunks_with_producer, ids=uuids)